Au début d'un projet IA, l'une des premières questions que nous posons porte sur l'étendue du projet, le nombre d'utilisateurs, les contraintes logicielles et l'hébergement de la solution cible. La localisation des données, l'infrastructure existante et le budget d'exploitation pèsent sur les choix techniques au moins autant que le cas d'usage lui-même. Voici trois projets récents, menés dans des contextes très différents, et la manière dont ces éléments ont orienté l'architecture.
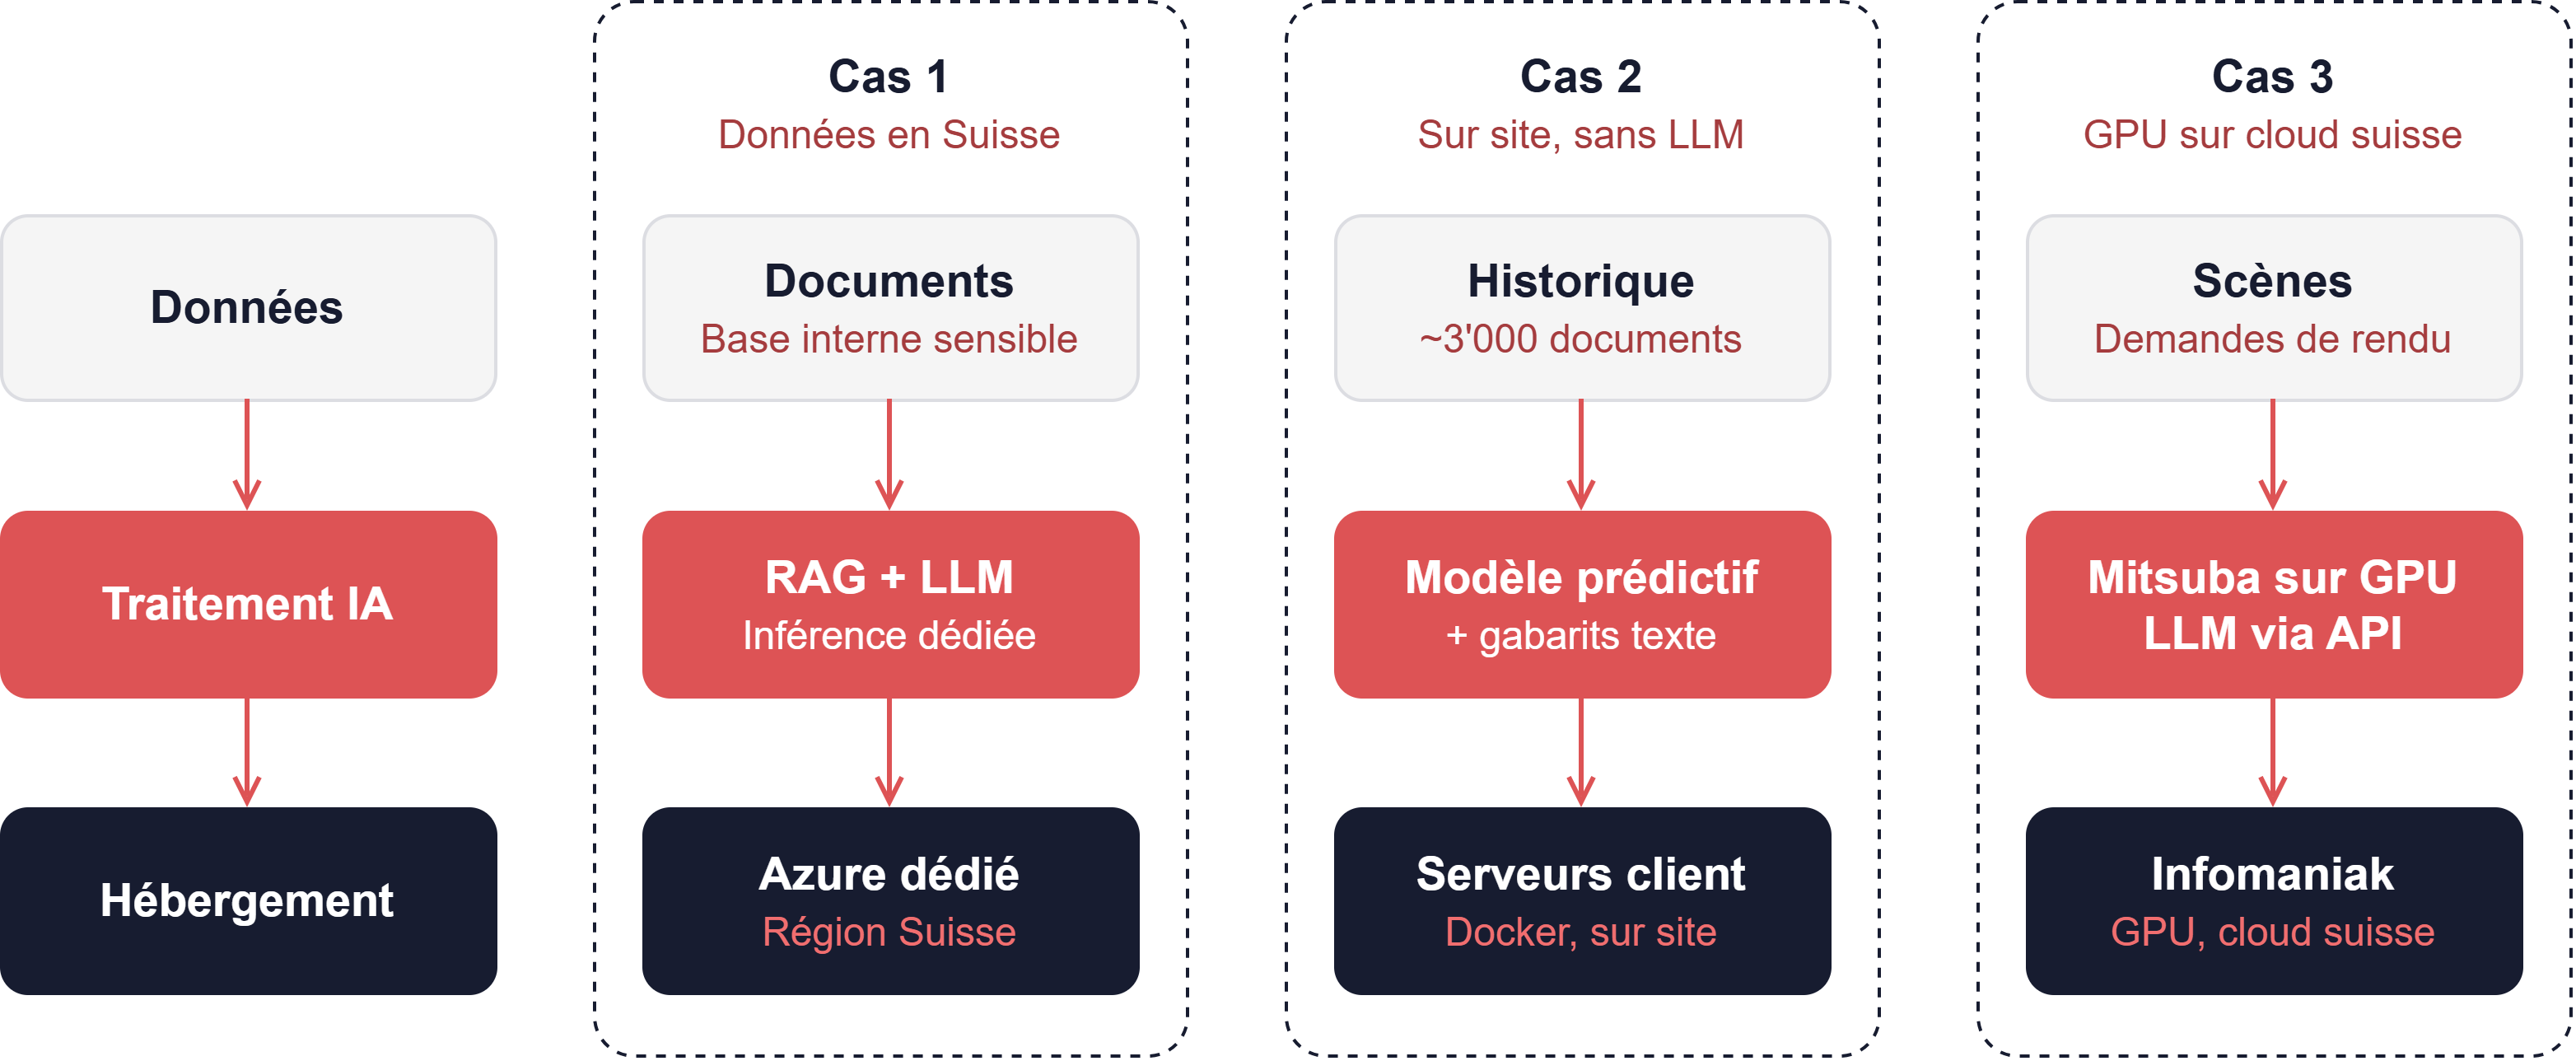
Cas 1 Générer des réponses à appels d'offres, avec des données qui restent en Suisse
Ce client souhaitait aider ses équipes à rédiger des réponses à appels d'offres à partir de sa documentation interne. Ces documents étant sensibles, les données et leur traitement devaient rester en Suisse.
Nous avons mis en place un système RAG (recherche documentaire couplée à un modèle de langage) sur des ressources Azure dédiées, hébergées en Suisse, inférence LLM comprise. Les documents sont indexés, et le modèle s'appuie sur ce contenu pour proposer des réponses.
Ce choix limite les modèles utilisables à ceux qui sont disponibles dans la région. En contrepartie, le périmètre est clair : on sait où se trouvent les données et qui y accède.
Cas 2 Produire du texte sans LLM, sur une infrastructure entièrement interne
Ici, l'objectif était d'automatiser la rédaction de documents structurés, sur une infrastructure 100 % sur site. Faire tourner un LLM en local aurait demandé du matériel GPU et une exploitation dont le coût aurait été disproportionné par rapport au besoin.
Nous avons donc pris une autre voie. Un modèle de prédiction, entraîné sur environ 3'000 documents existants, détermine le contenu attendu. Le texte final est ensuite assemblé à partir de gabarits paramétrés, dont les valeurs sont récupérées automatiquement dans la base de données. Pour l'utilisateur, le résultat ressemble à du texte généré. Cette récupération automatique limite fortement les erreurs de saisie et représente un gain de temps précieux. Techniquement, la solution est plus légère et son comportement plus prévisible.
La solution n'a aucune dépendance externe, ses coûts sont stables et son fonctionnement reste facile à expliquer. Elle offre en revanche moins de souplesse rédactionnelle qu'un LLM, ce qui convenait à des documents au format assez régulier.
Cas 3 Rendu d'images haute fidélité sur un cloud suisse
Ce projet consiste à produire des rendus d'images photoréalistes, ce qui demande beaucoup de calcul.
Nous avons déployé Mitsuba, un moteur de rendu physique, sur une instance GPU chez Infomaniak. Pour l'instant, le GPU reste actif en permanence : au volume actuel, le coût reste modéré et l'exploitation simple. L'architecture permet toutefois d'activer plus tard des stratégies d'optimisation, comme l'allumage à la demande ou la mise en file des rendus, si l'usage augmente.
Un deuxième volet du projet porte sur la mise en scène de ces rendus. Les images concernées ne contenant pas de données sensibles, un appel à l'API Gemini (Nano Banana) suffit.